
Mayo de 2026
Cómo construí un agente que documenta proyectos enteros y los mantiene actualizados
Migrar sistemas que nadie tocó en años, sin documentación y sin nadie a quien preguntarle. La salida fue un agente que analiza un repositorio como lo haría yo si me lo dieran nuevo.
La documentación siempre fue el problema que todos mencionan y, ahora que empezó a ser un must, decidí resolverlo con un agentito.
El problema se volvió urgente cuando empezamos a migrar sistemas. Necesitaba entender proyectos que nadie había tocado en meses o años. Algunos con cientos de archivos. Ninguno con documentación útil o completa. Muchos creados por otros equipos, por lo que ni acceso al dev rockstar teníamos.
El agente-sistema
Construí un agente que analiza un repositorio como lo haría yo si me lo dieran nuevo.
A través de una conversación con un bot, configurás el proyecto (stack, repositorio, parámetros base). El bot descarga el repo y empieza a escanearlo.
Lo primero que hace es detectar el stack real. Un proyecto que parece ser solo Laravel puede incluir también Inertia y Vue. Eso implica múltiples stacks, tecnologías y arquitecturas. El agente lo detecta solo. Con ese contexto, genera un set de tareas y las va ejecutando.
Luego lee el contexto: README, variables de entorno, configuración. Después la estructura de carpetas — antes de entrar a un solo archivo, la arquitectura ya se empieza a leer en cómo está organizado el proyecto. Luego las dependencias: el composer.json, el package.json, lo que corresponda.
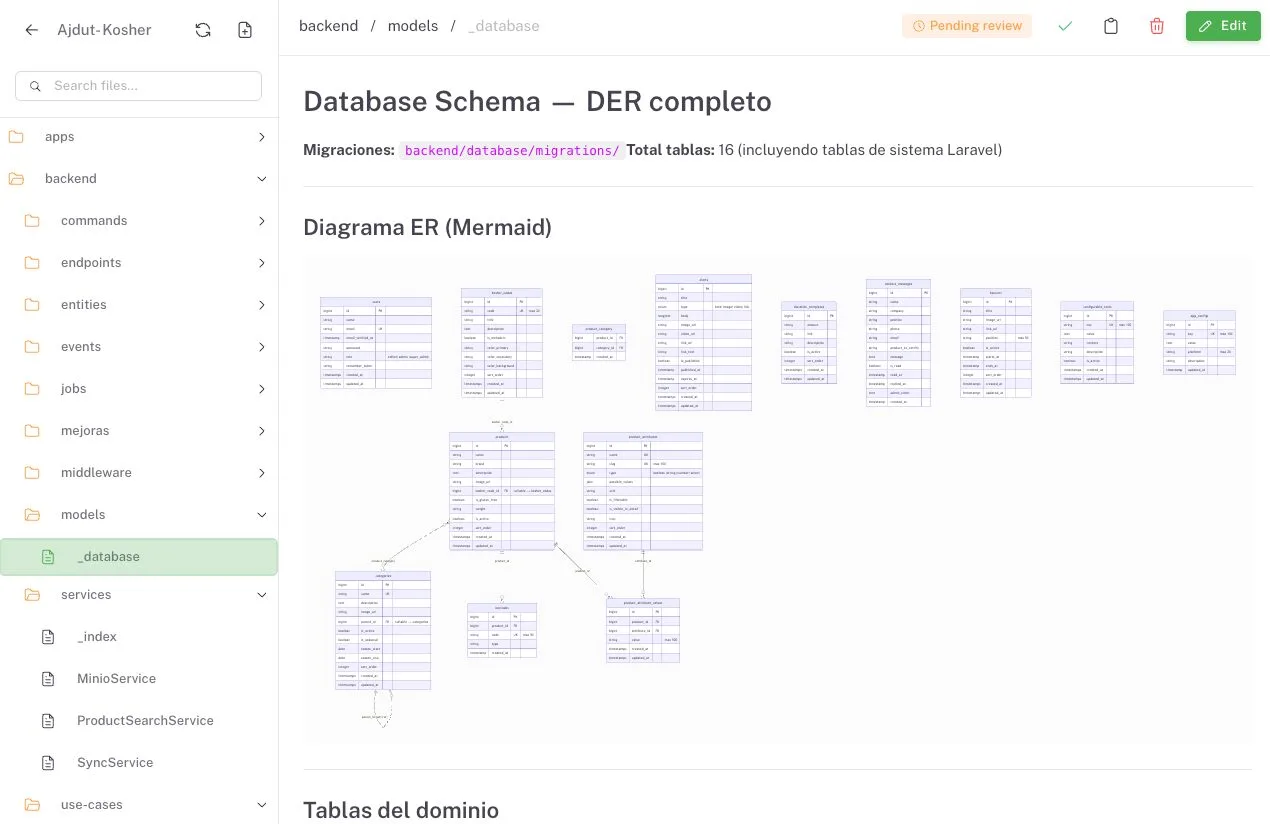
Con ese mapa base, entra al código. Endpoints, entidades, controladores, servicios, repositorios. Detecta jobs, schedulers, comandos. Y cierra con el schema de base de datos, donde está el modelo de negocio real, muchas veces más valioso que el código mismo.
Cuando detecta entidades complejas, crea subtareas para recorrer cada modelo con sus servicios, jobs, schedulers y demás. Construye el mapa de arquitectura completo.
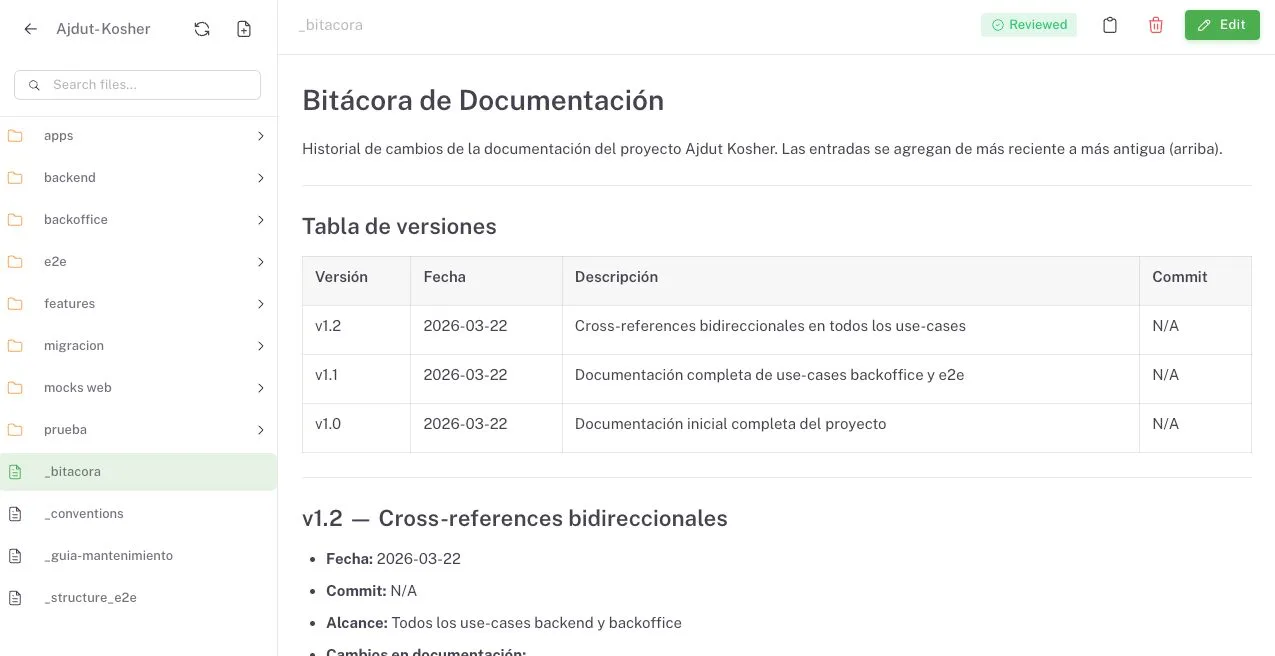
Todo queda guardado en una base de datos. Podés editarlo, consultarlo, aprobarlo. La documentación deja de ser un archivo y pasa a ser parte del flujo.
El nuevo desafío: mantenerla actualizada
Generar documentación una vez es fácil. El desafío es que no quede obsoleta.
La solución fue integrarlo al proceso de pull requests. Un agente toma los documentos existentes, el contexto del ticket, y actualiza lo que cambió. Cada vez que un documento se modifica, vuelve a estado pendiente de revisión. Hay bitácora completa: qué cambió, cuándo, en base a qué ticket.
El mismo sistema está disponible durante el desarrollo. Podés preguntarle por qué una función hace lo que hace —usando el MCP que desarrollé—, cuál fue la decisión de negocio detrás de un job. No solo qué hace el código, sino por qué lo hace.
La documentación no es un archivo. Es un sistema.
Si la tratás como archivo, se desactualiza. Si la tratás como sistema —con procesos, validaciones, integrada al flujo de trabajo— se convierte en algo que el equipo realmente usa.
Seguir leyendo
Otras notas.
Si algo de esto te suena
Media hora alcanza para saber si se puede.
Casi todo lo que escribo acá salió de un problema concreto de un equipo concreto. Si tenés uno parecido, contámelo.